深度学习入门
本文最后更新于 2026年9月27日 下午
认识深度学习
深度学习是机器学习的一个分支,它使用多层神经网络,从原始数据中自动学习特征,并完成预测和决策。
深度学习能做什么
深度学习广为人知是因为大模型和Transformer,但实际上它已经广泛应用在商品推荐、文本翻译、人脸识别、自动驾驶等场景中。
计算机视觉(CV)
主要处理图像和视频数据。
常见任务:图像分类、目标检测、人脸识别、图像分割、缺陷检测
典型应用:手机“拍照识花”、工厂瑕疵检测、医疗 CT 辅助诊断、自动驾驶环境感知
自然语言处理(NLP)
主要处理文本和语言数据。
常见任务:机器翻译、问答系统、文本分类、情感分析、文本生成
ChatGPT 的底层核心技术就属于 NLP 领域中的深度学习模型。
智能语音
主要处理语音和音频数据。
常见任务:
- 语音识别(ASR):把语音转换成文字
- 语音合成(TTS):把文字转换成语音
- 声纹识别:根据声音识别说话人
典型应用:手机语音助手、智能音箱、实时字幕、智能客服
推荐系统与时间序列
深度学习也常用于推荐和预测任务。
推荐系统:短视频推荐、电商商品推荐、新闻推荐、广告推荐
时间序列:股价预测、电网负荷预测、销量预测、设备状态预测
核心特点
深度学习特别适合处理:图像、文本、语音、视频、复杂时序数据
它的优势在于能够通过多层神经网络,自动从大量数据中学习复杂的特征表示,而不完全依赖人工设计特征。
为什么传统机器学习不够用
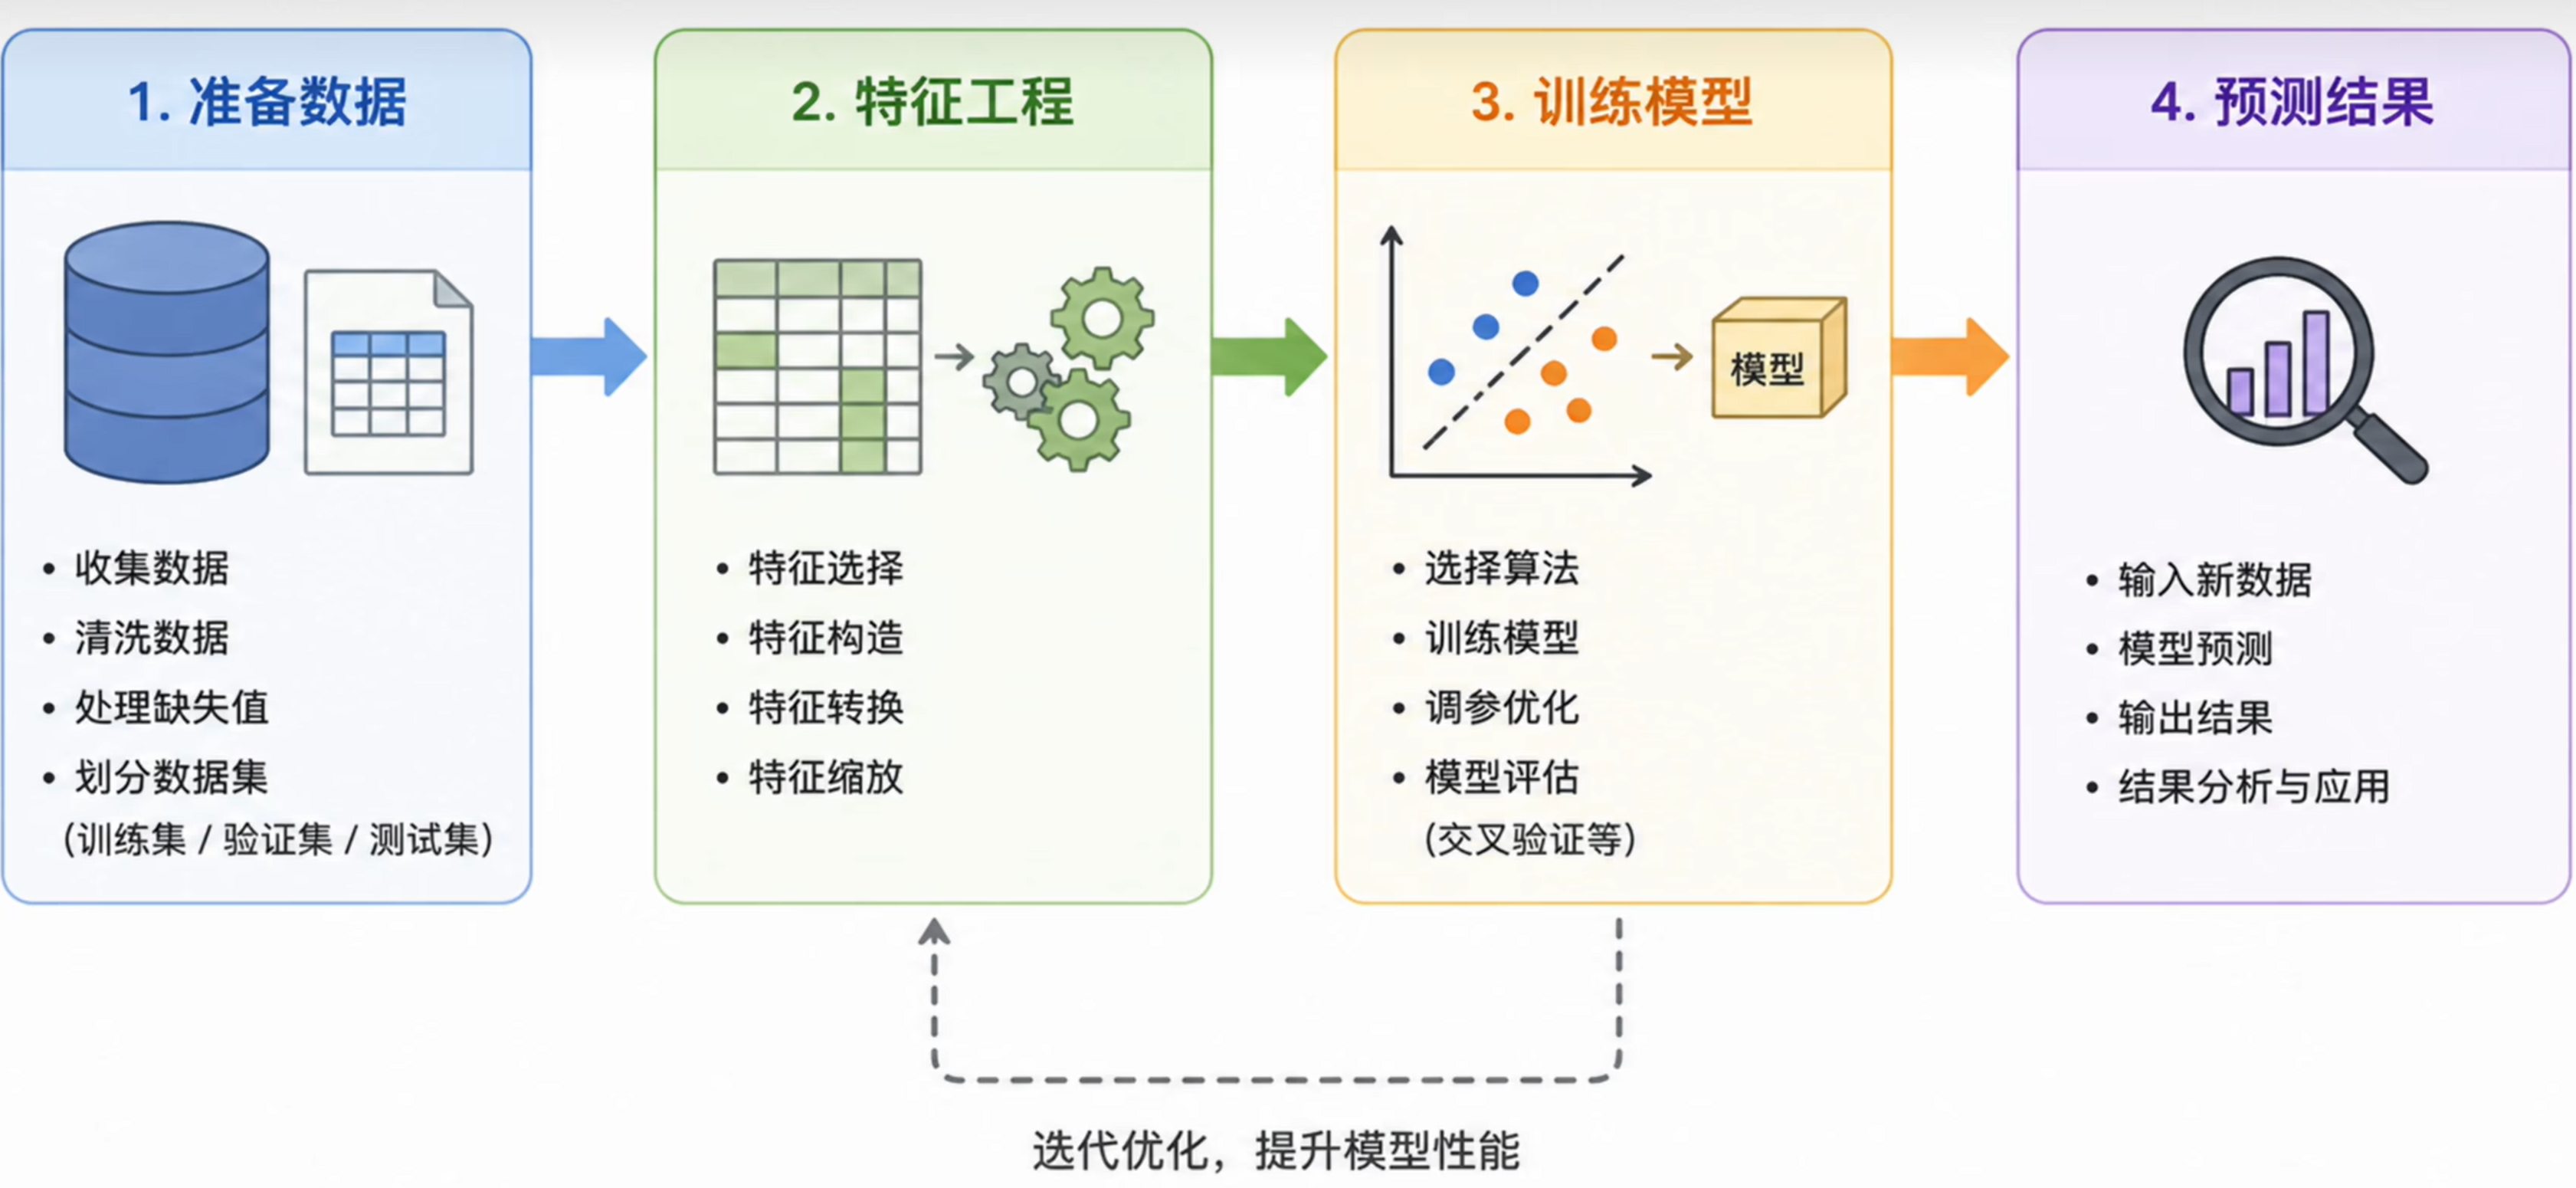
传统机器学习的标准流程通常包括:
- 准备数据
- 特征工程
- 训练模型
- 预测结果
其中,特征工程尤其关键,并且高度依赖人工经验。
传统机器学习流程
传统机器学习的局限
传统机器学习课程中常见的数据集,例如:加州房价、泰坦尼克号、表格分类数据
这些大多属于结构化数据,即二维表格形式的数据。
但现实世界中,大量数据属于非结构化数据,例如:图像、文本、语音、视频
对于这类数据,传统机器学习通常需要人工设计和提取特征。
例如,要识别图片中的猫,可能需要人工设计:耳朵形状、眼睛形状、毛发纹理、轮廓特征
核心问题
传统机器学习通常依赖:
人工特征工程 + 模型学习
而面对图像、文本、语音等复杂数据时,人工设计特征的成本非常高,并且很难覆盖所有有效信息。
深度学习的优势
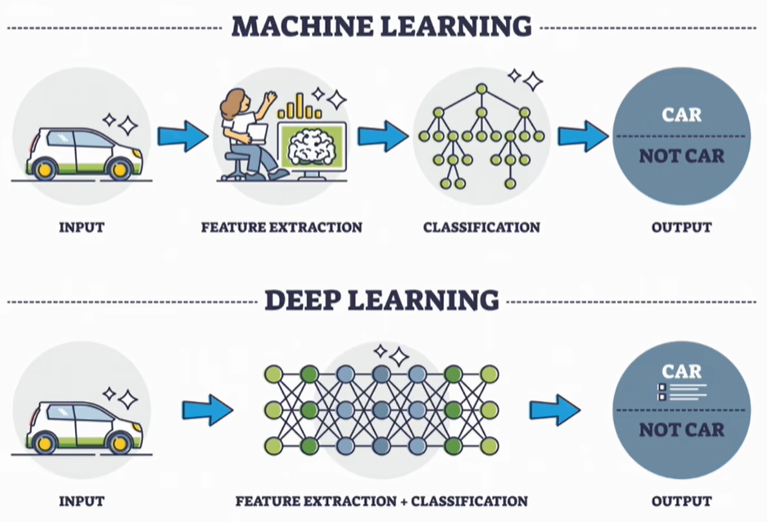
深度学习的重要突破之一,就是能够直接从原始数据中自动学习特征表示。
因此可以将传统流程:
原始数据 → 人工特征工程 → 模型 → 预测
简化为:
原始数据 → 深度神经网络自动学习特征 → 预测
这也是深度学习特别适合图像、文本、语音等非结构化数据的重要原因。
传统特征提取的核心瓶颈
1. 严重依赖领域专家
图像需要图像处理专家,语音需要信号处理专家。每一次更换领域就需要重新设计特征,成本高且难复用。
2. 复杂数据无从下手
人工可以定义“猫耳朵”,但无法定义一段话的“语气”或一张图里的“欢乐氛围”。高层次语义概念难以用手工特征描述。
3. 特征的天花板就是模型的天花板
特征设计得不好,再强的模型也救不了。模型的表现上限被人工特征的质量死死卡住。
深度学习的思路转变
既然让人类去定义特征如此困难,为什么不让机器自己去海量数据中总结?
深度学习核心创新:
把特征提取也纳入了学习过程本身!
从像素到概念:逐层抽象
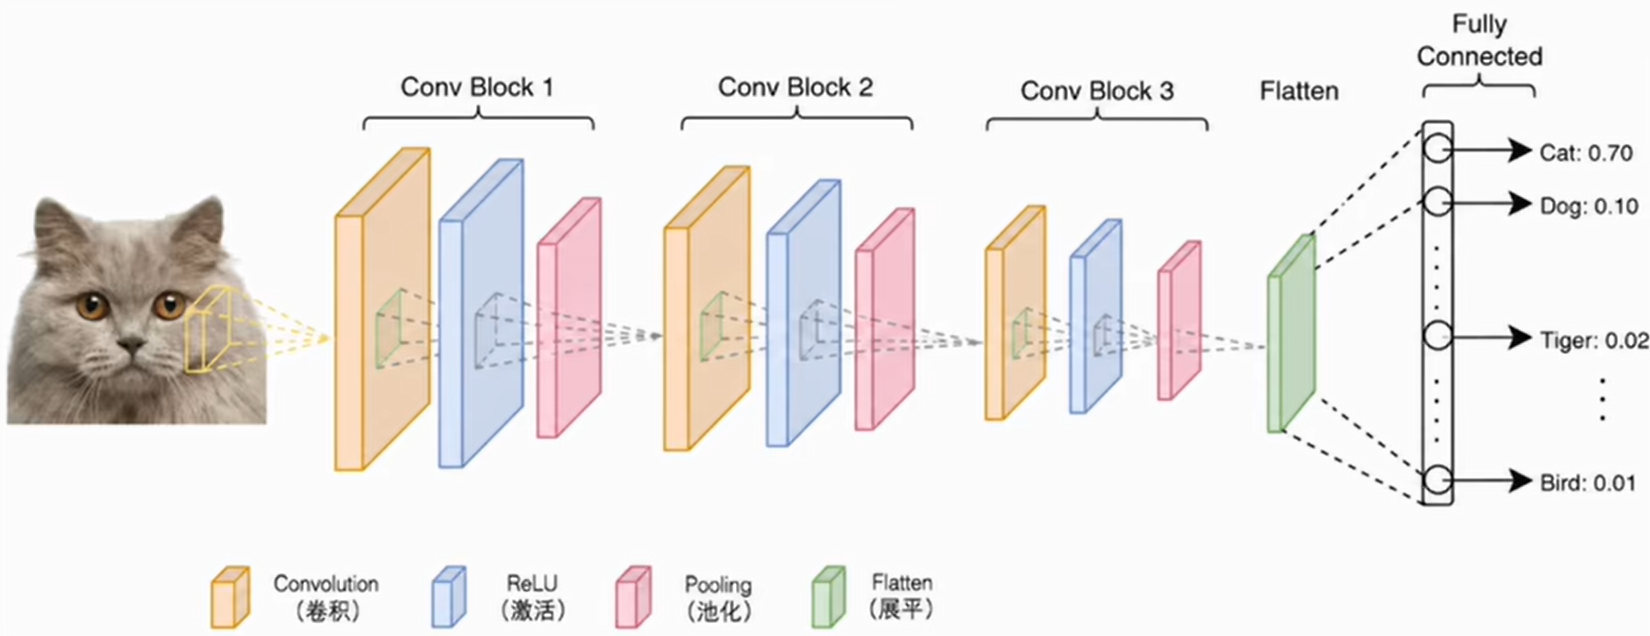
第一层
识别基础视觉元素:横线、竖线、颜色边缘。
中间层
组合基础元素识别复杂结构:弧线、纹理块、局部形状。
更深的层
识别高层特征:三角形耳朵、胡须的细线条。
最后一层
综合所有特征,输出最终预测概率:97% 是猫。
图示流程
输入图像 → Conv Block 1 → Conv Block 2 → Conv Block 3 → Flatten → Fully Connected → 分类概率
重新理解深度学习的定义
关键在于,这些特征不是人告诉它的,而是它自己从大量数据中学出来的。准备好数据和标签,模型就会不断调整参数,越判越准。
多层神经网络:
逐层堆叠的网络结构,模拟大脑逐级抽象。
自动学习特征:
特征提取不再依赖人工,机器自己总结规律。
原始数据:
直接输入未经处理的底层信息(如 RGB 像素值、波形音频)。
感知机:深度学习的 Hello World
什么是感知机?
感知机,是给定一组输入数据,自动找到一条决策边界,将不同类别的数据正确区分开来的机器。
它是人类历史上第一个真正落地的可学习机器方案,让机器不再依赖人工编写的规则,而是自动从数据中学会分类。
虽然诞生于 1957 年,但它麻雀虽小,五脏俱全。完整包含了神经网络所有核心要素的雏形:输入、权重、求和、激活、误差反馈、参数更新。真正理解了感知机,就相当于掌握了神经网络的完整骨架。
让机器学会分类
感知机的工作原理非常简单:对输入做加权求和,与阈值比较做出判断,根据错误反馈微调修正权重,直到学会正确分类。
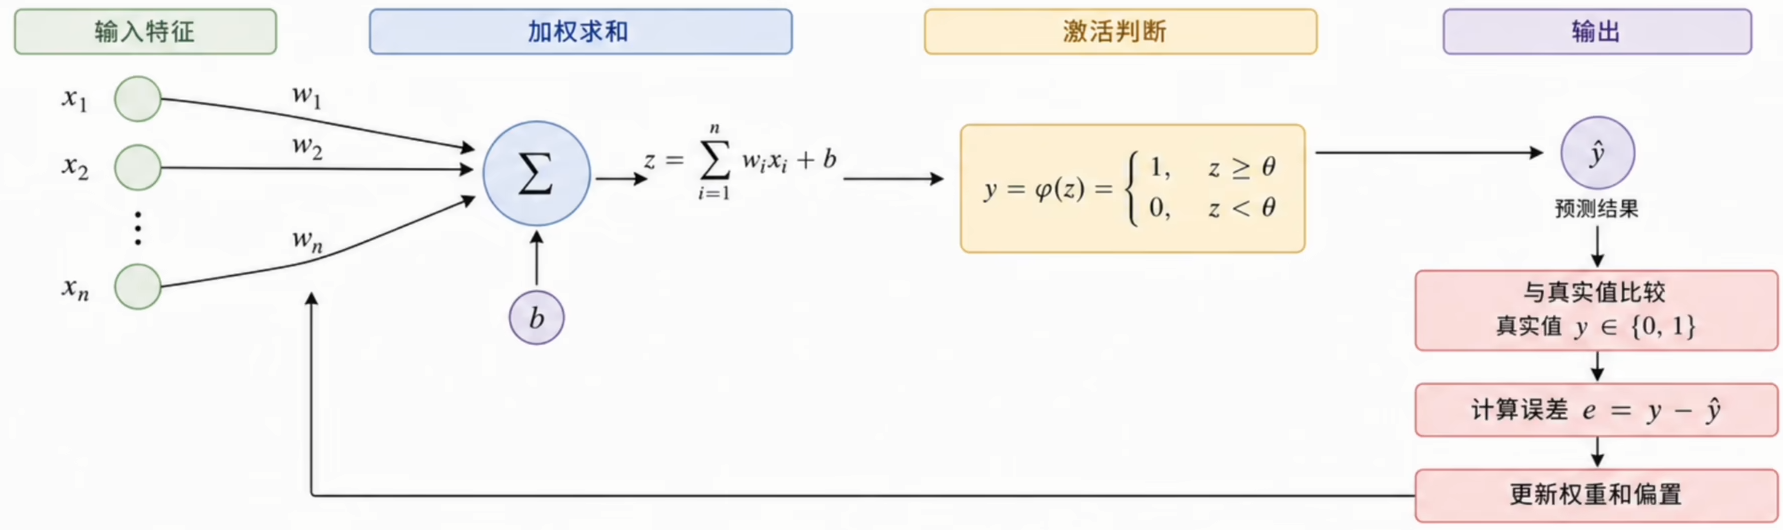
如果有机器学习的基础,会发现把感知机的激活函数(阶跃函数)改成 Sigmoid 就是逻辑回归。
感知机执行步骤
第一步:输入与加权
接收一组输入信号 \(x_i\),每一个输入代表数据的某个特征。
每一个输入对应一个权重 \(w_i\),权重的大小代表这个特征对最终判断的影响程度。
- 权重越大,这个特征越关键。
- 权重接近零,说明这个特征几乎可以忽略。
- 这正是对赫布理论的直接呼应——连接越强,影响越大。
第二步:求和与判断
把加权后的输入全部加起来,得到数值 \(z\):
\[ z=w_1x_1+w_2x_2+w_3x_3+b \]
其中 \(b\) 是偏置项(Bias),相当于对判断基准线的微调。得到 \(z\) 之后进行激活判断:
\[ \hat{y}= \begin{cases} 1, & \text{若 } z\ge 0 \\ 0, & \text{若 } z<0 \end{cases} \]
第三步:错误与修正
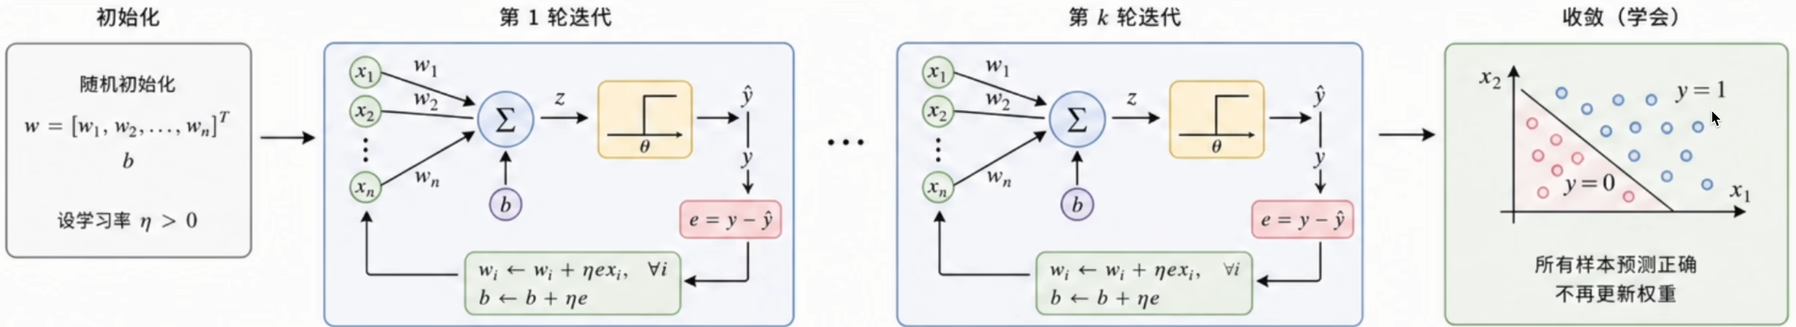
每做出一次预测,感知机就把结果和正确答案对比。如果预测正确,什么都不用做;如果预测错误,就按照下面的规则调整权重:
\[ w_i \leftarrow w_i+\eta\cdot(y-\hat{y})\cdot x_i \]
- \(y\) 是正确答案,\(\hat{y}\) 是感知机的预测,两者之差是误差信号。
- \(x_i\) 是特征的输入值,误差要按照输入的大小来分配责任。
- \(\eta\) 是学习率,控制每次调整的幅度。
案例:预测身材偏胖还是偏瘦
为了让感知机的工作过程更直观,我们来做一个具体的案例:判断一个人的身材是偏胖还是偏瘦。
- 输入特征: 收集一批人的数据,提取两个特征:\(x_1\)(身高)和 \(x_2\)(体重)。
- 数据处理: 消除身高和体重的量级差异,将数据压缩到 0~1 之间(归一化),保证学习稳定。
- 目标标签: 偏瘦标记为 0,偏胖标记为 1。
- 训练过程: 让感知机从对特征一无所知(权重为 0)开始,不断看数据、预测、对比、修正权重。
当感知机对所有样本都能给出正确的预测时,它就找到了那条完美的“决策边界”。
MLP到神经网络的升级,理解反向传播的基础
复杂功能可以由简单模块组合
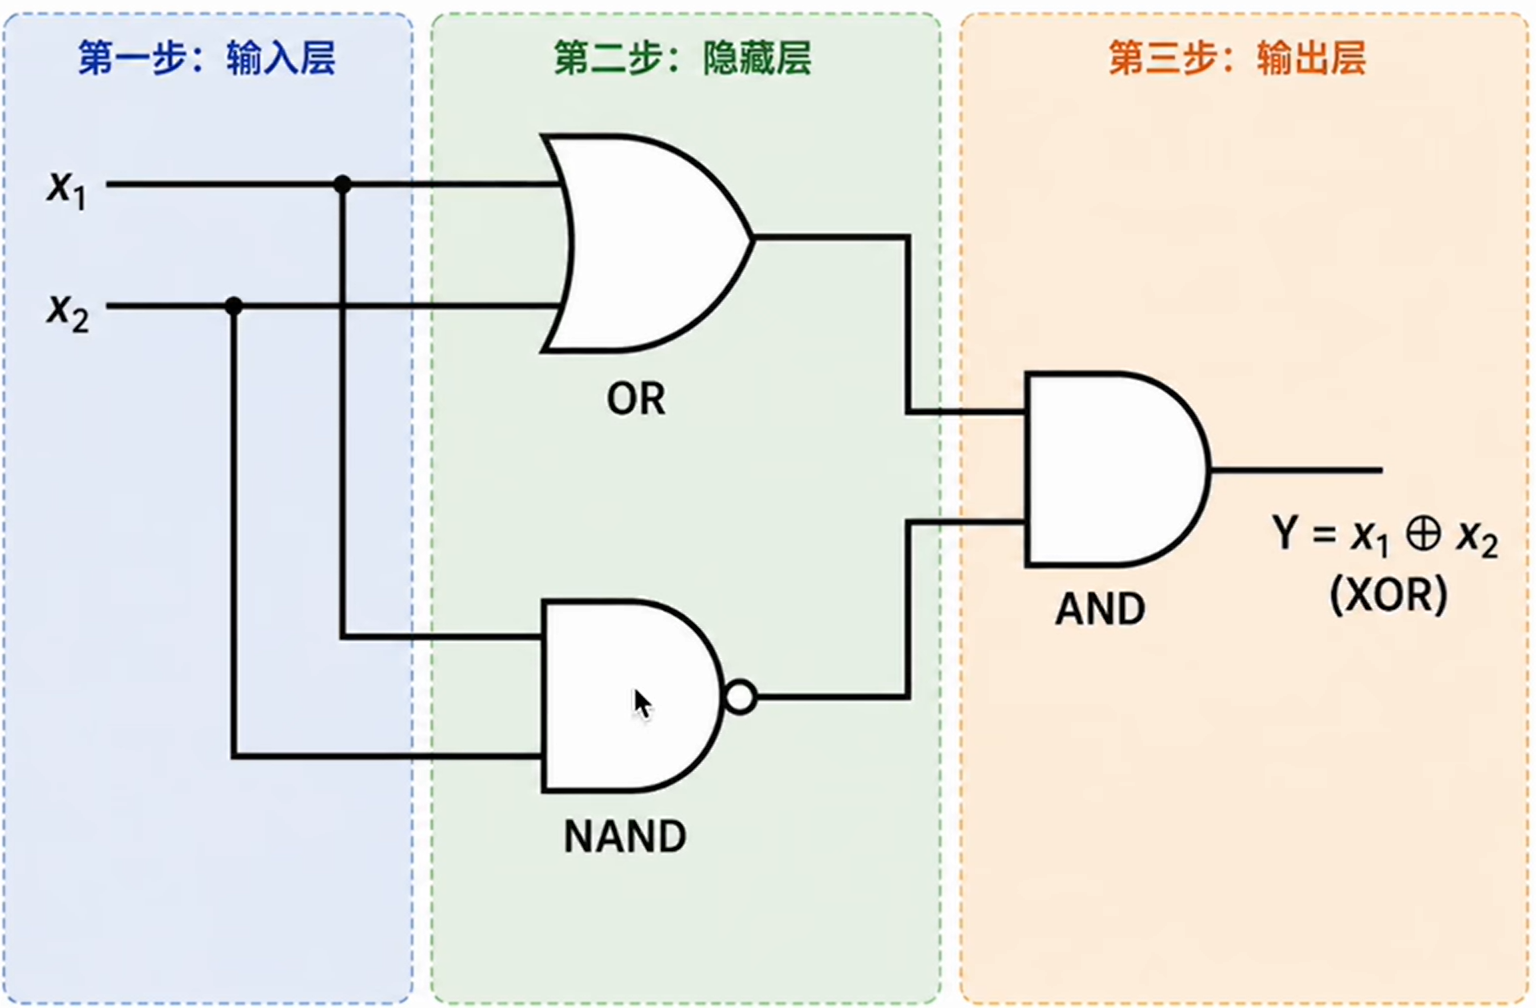
XOR 问题在逻辑电路中早已解决,计算机的异或门是由更基础的门电路组合而成的。
- \(x_1 \text{ OR } x_2\):至少一个输入为 1
- \(\text{NOT}(x_1 \text{ AND } x_2)\):两个输入不能同时为 1
核心思想
复杂功能可以由简单模块层层组合得到。
多条线围出复杂区域
把基础功能的感知机组合堆叠,就可以解决异或这样的复杂问题。
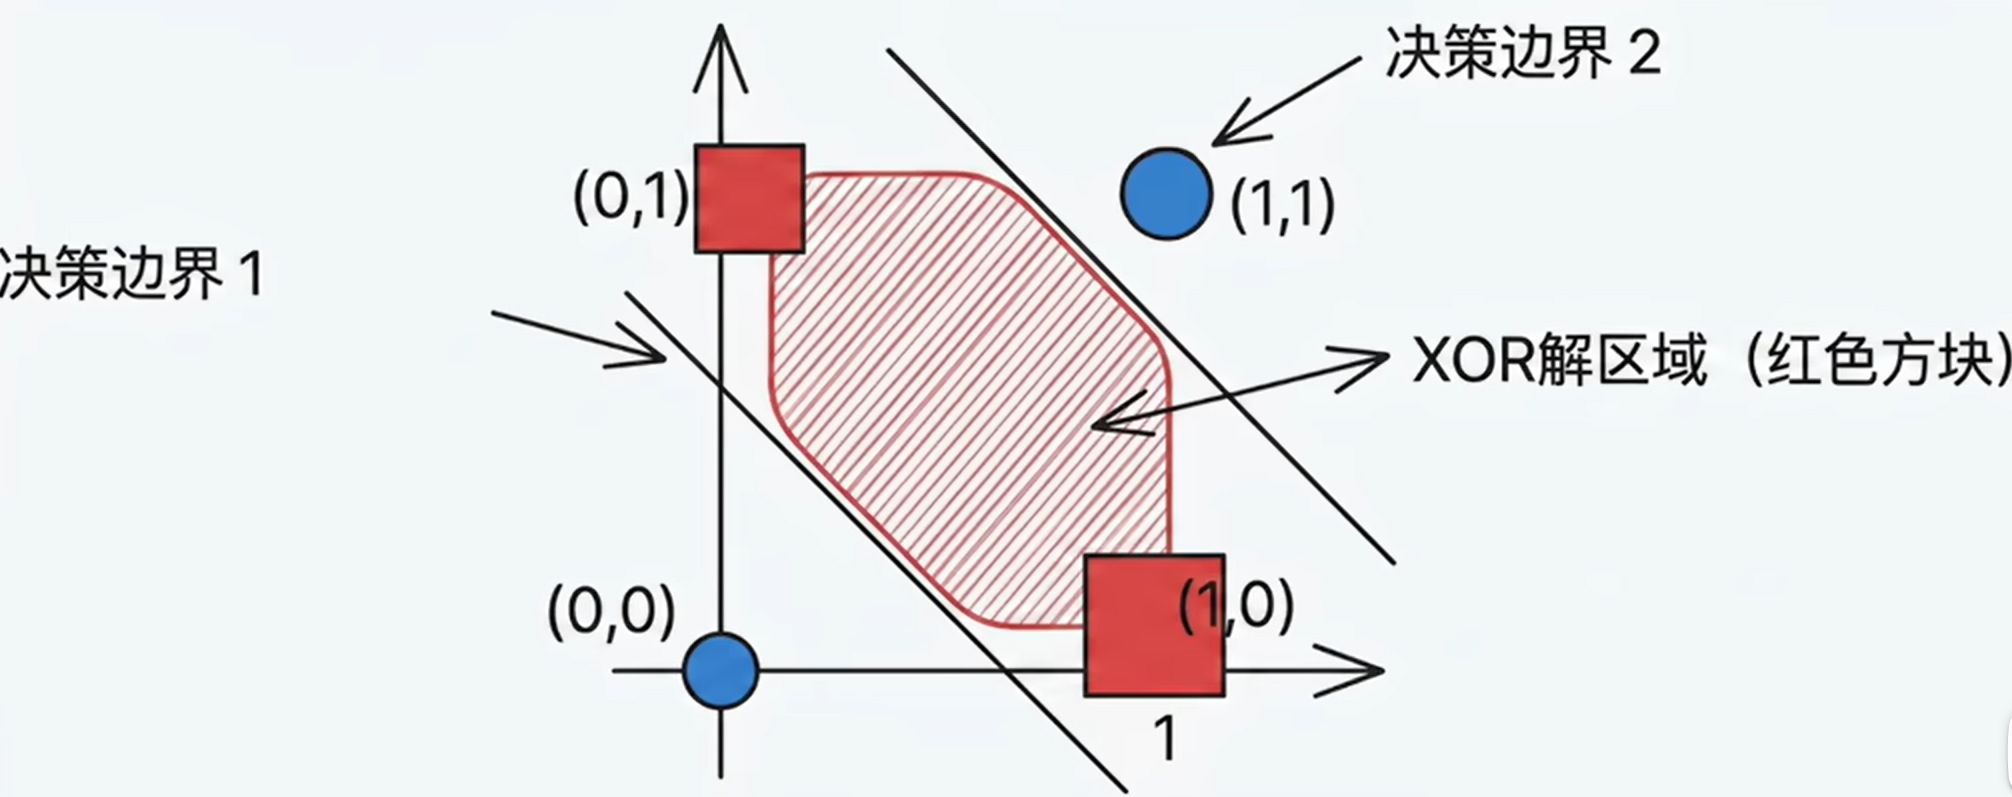
- 单个感知机在特征空间里画一条直线,只能做线性分割。
- 如果有两个感知机,就有两条线;三个感知机就有三条线。
- 多条线就可以围出任意复杂的区域。
用两层感知机解决 XOR
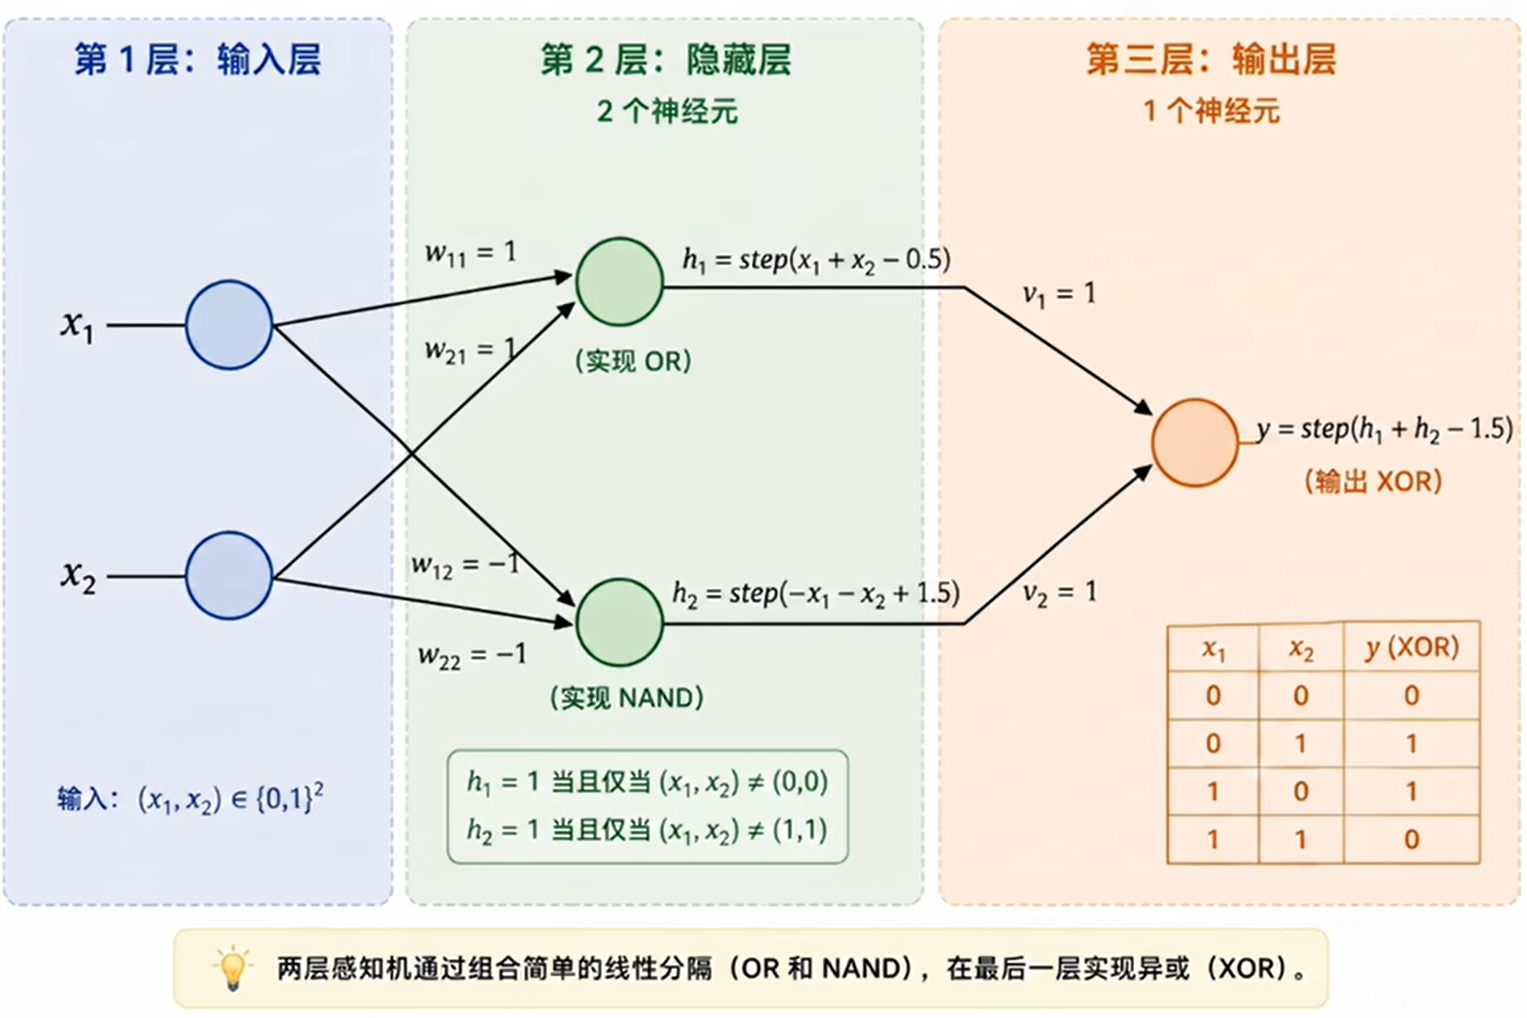
- 输入层: 接收两个特征 \(x_1\)、\(x_2\)
- 隐藏层: 两个神经元使用不同的权重做并行运算,各自画一条分割线,输出 0 或 1
- 输出层: 将隐藏层的两个输出作为输入,再做一次加权求和与激活,得到异或判断
第一个隐藏神经元学会了至少一个输入为 1,第二个学会了不能同时为 1,输出层把两个条件取交集。
多层感知机的一般结构
多个感知机按层排列、层间全连接,构成了多层感知机(MLP)。
- 输入层接收原始特征,数个隐藏层进行中间运算,输出层给出最终结果。
- 同一层里的神经元并行提取多个不同的特征或规则。
- 后续层将前一层的输出作为输入,利用不同的权重进一步组合,逐层构造出更抽象、更有用的表示。
数学表达:函数的层层嵌套
\[ \text{output}=h_n\left(h_{n-1}\left(\cdots h_2\left(h_1(X)\right)\right)\right) \]
层函数
\[ h_i(x)=\sigma_i(W_i x+b_i), \quad i=1,2,\ldots,n \]
整体输出
\[ \text{output}=(h_n\circ h_{n-1}\circ\cdots\circ h_1)(X) \]
为什么多层线性变换无效
如果每一层只是做线性变换,那么无论堆多少层都是徒劳的。
假设第一层输出为:
\[ h=W_1x+b_1 \]
第二层输出为:
\[ y=W_2h+b_2 \]
代入第一层:
\[ y=W_2(W_1x+b_1)+b_2 \]
整理得:
\[ y=(W_2W_1)x+(W_2b_1+b_2) \]
令:
\[ W'=W_2W_1,\qquad b'=W_2b_1+b_2 \]
则:
\[ y=W'x+b' \]
也就是说,多层线性变换最终仍然等价于一层线性变换。
线性变换的组合仍然是线性变换。层层叠加,做的全是无用功。
使用激活函数打破线性难题
解决方案是在每个神经元的加权求和输出上,套一个非线性函数,称为激活函数(Activation Function):
\[ h=f(Wx+b) \]
有了非线性的 \(f\),层与层之间的组合就无法再被化简为单一线性变换。
阶跃函数(Step Function)
\[ \operatorname{step}(z)= \begin{cases} 1, & \text{若 } z\ge 0 \\ 0, & \text{若 } z<0 \end{cases} \]
如何训练模型仍旧是个问题
既然多层网络能力这么强,为什么还会经历长达二十年的寒冬?
- MLP 的结构在 1960 年代就已经被提出。问题不是没人想到多层,而是没法训练。
- 当时的感知机学习规则只适用于单层网络。
- 核心难题:隐藏层的误差该怎么分配? 输出层的错误我们看得到,但中间那些隐藏神经元,每个该为最终错误承担多少责任?没人知道怎么算这个梯度。
直到 1986 年,反向传播算法(Backpropagation)与多层网络结合,提供了一套高效计算多层梯度的方法。
反向传播:海量参数的神经网络如何训练
反向传播的本质:从最终结果出发,逐层倒推的责任分配机制。谁对误差影响越大,参数调整就越大。
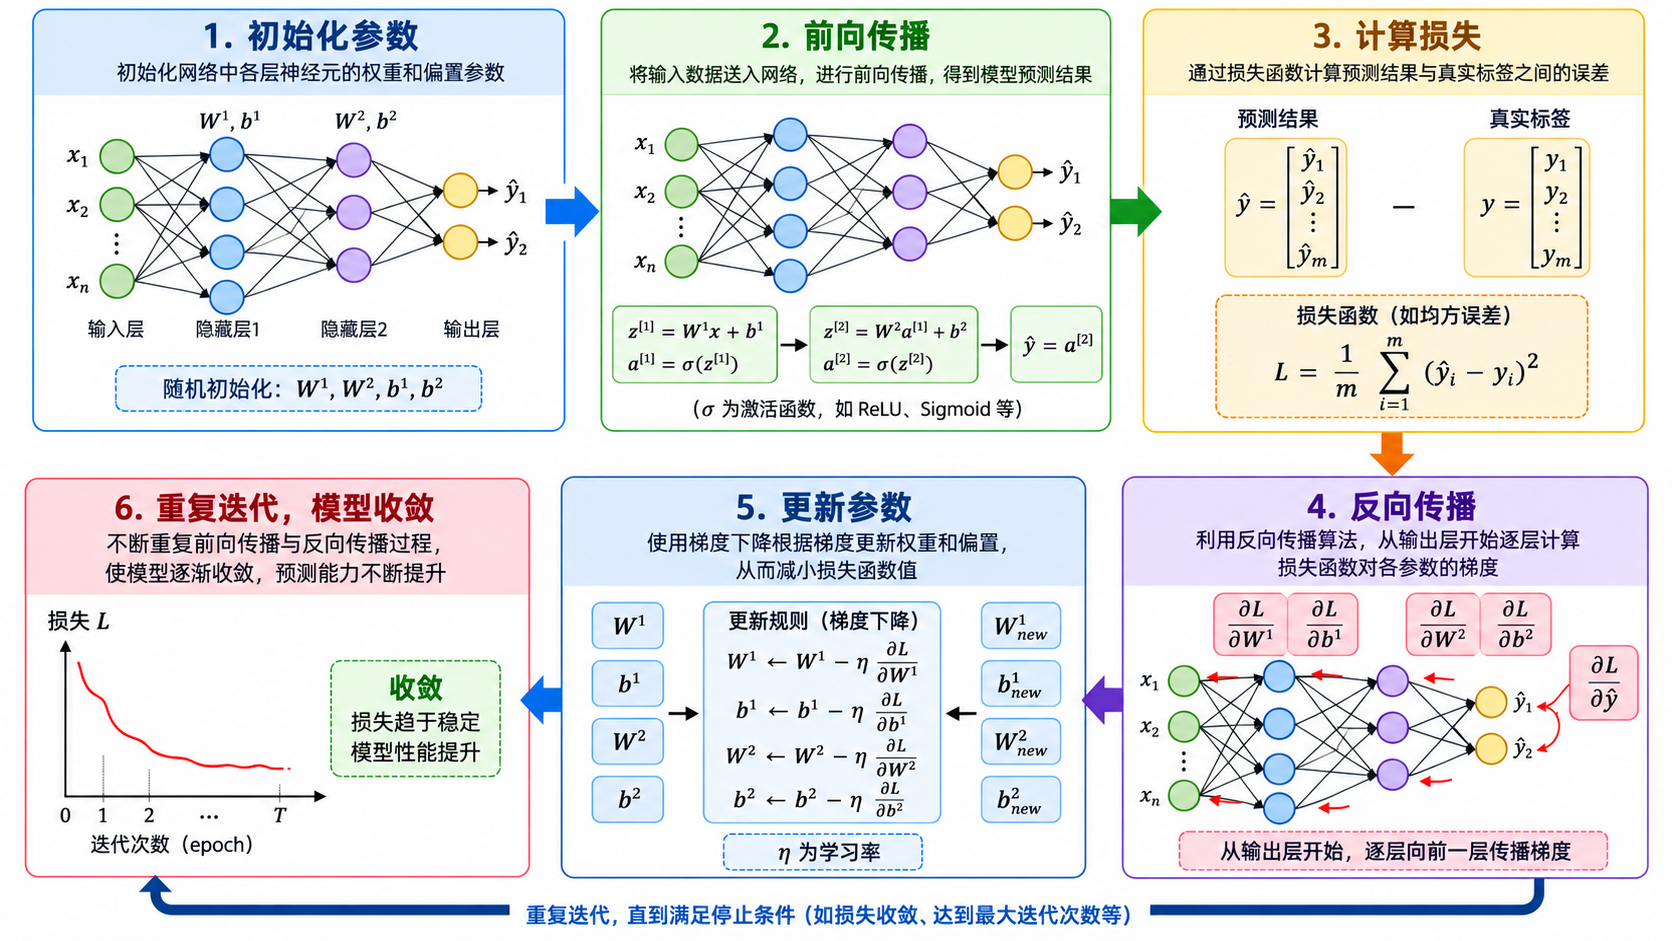
前向传播——模型用参数做预测
数据沿网络从输入流向输出:线性加权 → 加偏置 → 激活函数,把信息重构为更高阶特征传递给下一层。
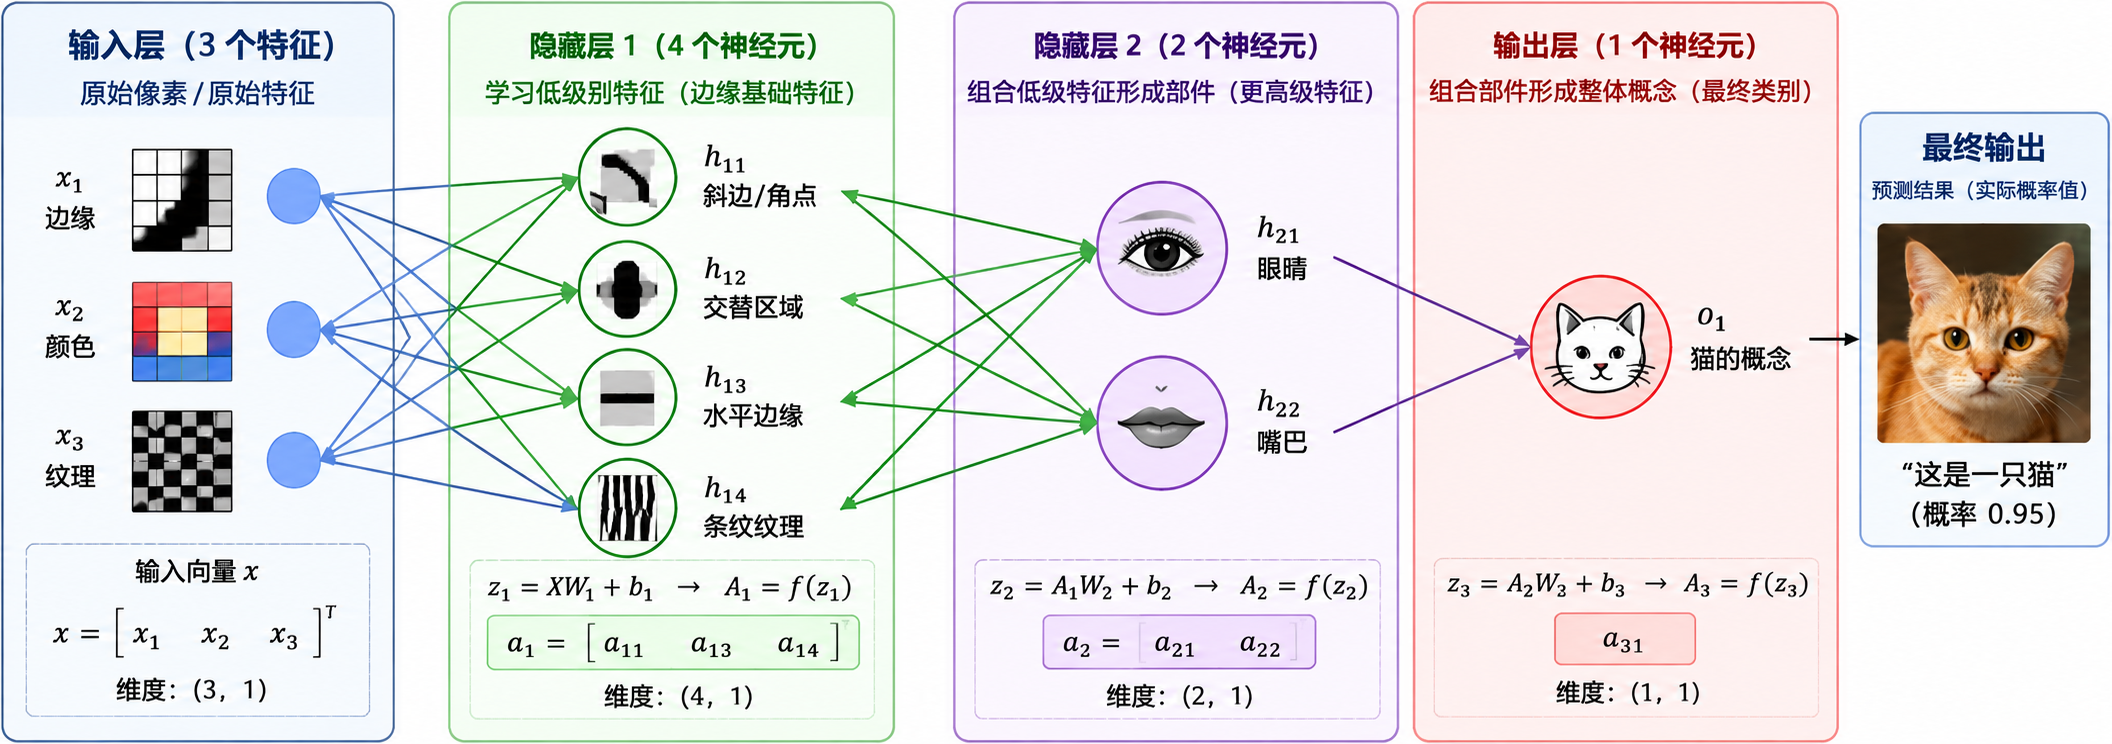
正是这种逐层抽象的机制,让神经网络具备了自动学习特征的能力。
每个神经元都做同一套两步操作
① 线性变换
\[ z=w_1x_1+w_2x_2+\cdots+w_nx_n+b \]
② 非线性激活
\[ a=\sigma(z) \]
差别只在于:每个神经元维护着自己的一套权重和偏置。以下图为例(3 输入 \(\rightarrow\) 4 神经元):
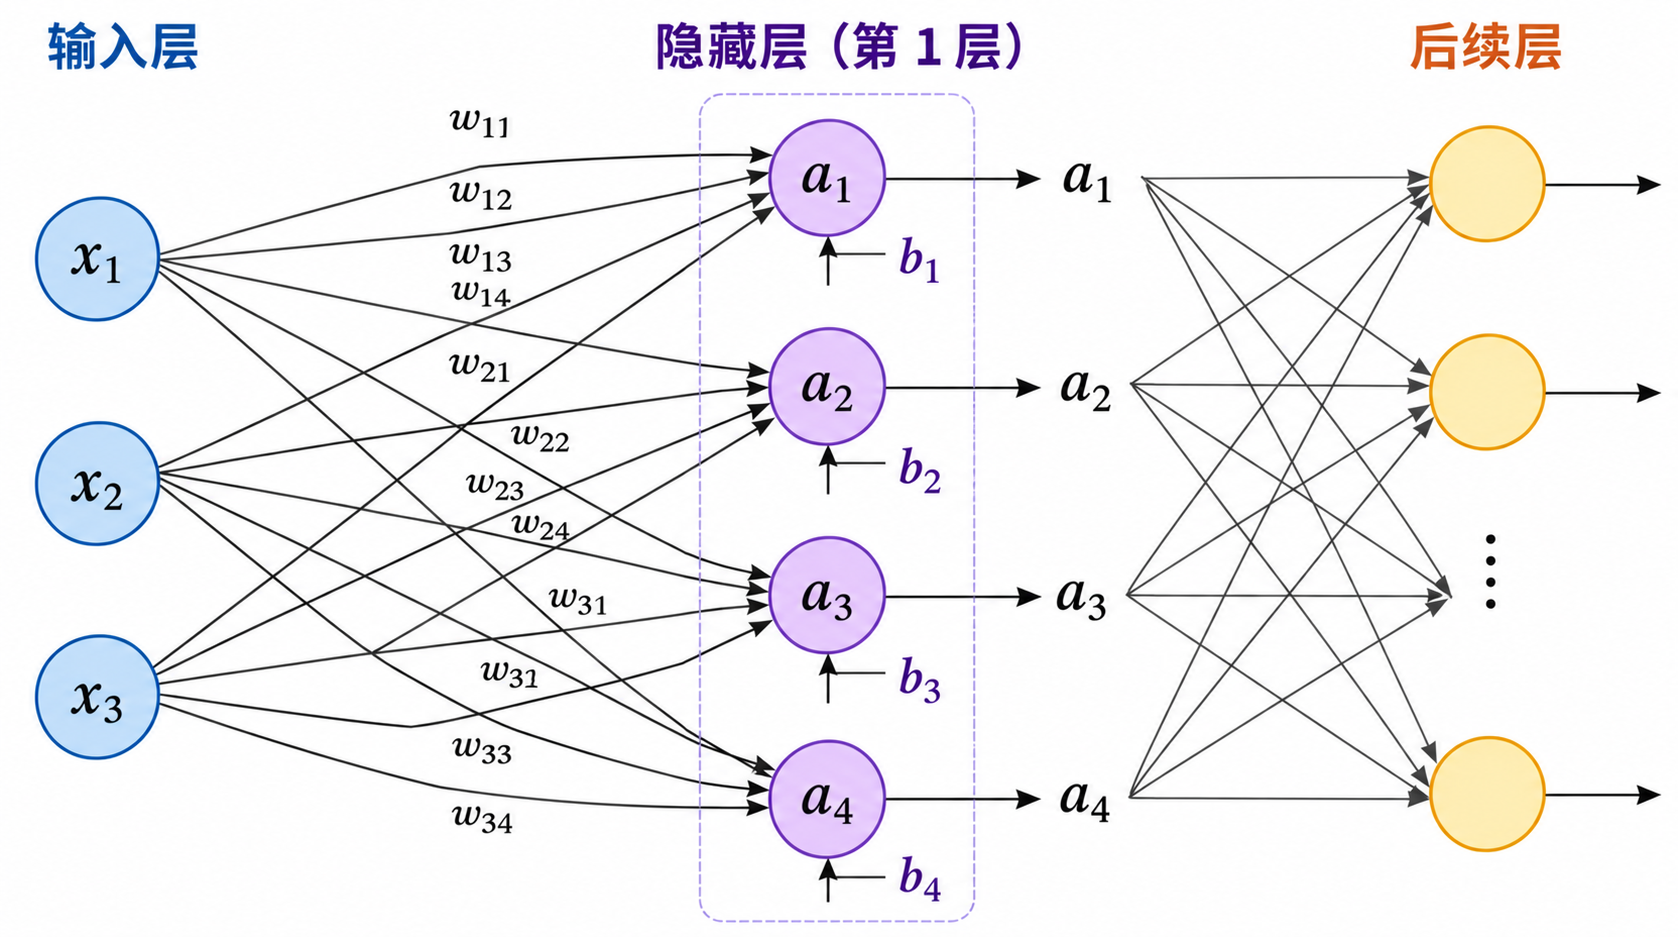 \[
a_1=\sigma(w_{11}x_1+w_{12}x_2+w_{13}x_3+b_1)
\]
\[ a_2=\sigma(w_{21}x_1+w_{22}x_2+w_{23}x_3+b_2) \]
\[ a_3=\sigma(w_{31}x_1+w_{32}x_2+w_{33}x_3+b_3) \]
\[ a_4=\sigma(w_{41}x_1+w_{42}x_2+w_{43}x_3+b_4) \]
从单神经元到整层矩阵化
第 \(l\) 层第 \(i\) 个神经元的输出(通项形式):
\[ a_i^{(l)}=\sigma\left(\sum_{j=1}^{n}w_{ij}^{(l)}a_j^{(l-1)}+b_i^{(l)}\right) \]
为了运算效率,把同一层所有神经元打包成矩阵,一次乘法搞定整层:
\[ \mathbf{A}^{(l)} = \sigma\left( \mathbf{W}^{(l)}\mathbf{A}^{(l-1)} + \mathbf{b}^{(l)} \right) \]
这就是为什么神经网络计算天然适合 GPU——它本质上就是一连串大型矩阵乘法。
矩阵化示例:3 输入 → 4 神经元
\[ \mathbf{A}^{(1)} = \sigma\left( \begin{bmatrix} w_{11} & w_{21} & w_{31} \\ w_{12} & w_{22} & w_{32} \\ w_{13} & w_{23} & w_{33} \\ w_{14} & w_{24} & w_{34} \end{bmatrix} \begin{bmatrix} a_1^{(0)} \\ a_2^{(0)} \\ a_3^{(0)} \end{bmatrix} + \begin{bmatrix} b_1^{(1)} \\ b_2^{(1)} \\ b_3^{(1)} \\ b_4^{(1)} \end{bmatrix} \right) \]
一次矩阵乘法就算完了 4 个神经元,比逐个循环高效几个数量级。
损失函数:把“错得多离谱”量化
前向传播得到 \(\hat{y}\),但它和真实标签 \(y\) 总有差距。我们用损失函数把这个差距量化为一个数:
线性回归常用 MSE(均方误差):
\[ \mathcal{L}=\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2 \]
\(\mathcal{L}\) 越大,说明错得越离谱。问题随之而来:该怎么调整权重矩阵 \(W\) 和偏置 \(b\),才能让 \(\mathcal{L}\) 变小?
线性回归、逻辑回归里的答案是梯度下降:算出损失对每个参数的偏导,组成向量——梯度,它指向损失上升最快的方向。要让损失下降,沿负梯度方向走一小步即可:
\[ W\leftarrow W-\eta\cdot\frac{\partial\mathcal{L}}{\partial W} \]
问题:神经网络计算梯度
神经网络会复杂很多,每层输出又是下一层的输入:
\[ a^{(l)}=\sigma\left(\sum_{i=1}^{n}w_i a^{(l-1)}+b\right) \]
这是典型的复合函数嵌套,而且嵌套了好多层。要算损失对深处某个参数的偏导,必须借助强大的数学工具——链式法则。
反向传播——沿计算图寻找“背锅侠”
→ 前向传播
沿箭头方向计算每个节点的值。
← 反向传播
逆着箭头方向,用链式法则把局部梯度一路乘回输入端。
计算图的妙处
复杂的多元复合求导被简化成“沿路径相乘局部梯度”。
每个节点只需关心自己的输入输出——这正是 PyTorch 等框架自动微分的基石。